AI战争:“巴拿马”焚书计划,Anthropic的反人类犯罪!
引言 2024年初,Claude的母公司Anthropic面临一个棘手的法律处境:它已从盗版书库LibGen和PiLiMi下载了数百万本书用于训练模型,版权诉讼接踵而至。如何继续获取高质量训练数据,又不触犯法律?
答案是一项秘密工程。代号“巴拿马”。
据《华盛顿邮报》从四千多页解封法庭文件中挖出的细节,Anthropic内部文件将该计划描述为“破坏性扫描世界上所有书籍”,并附一条明确指示:“不希望外界知道我们在做这件事。”
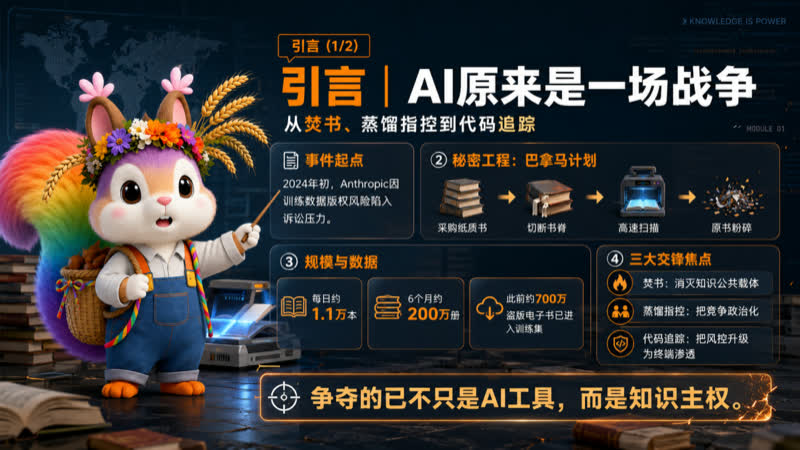
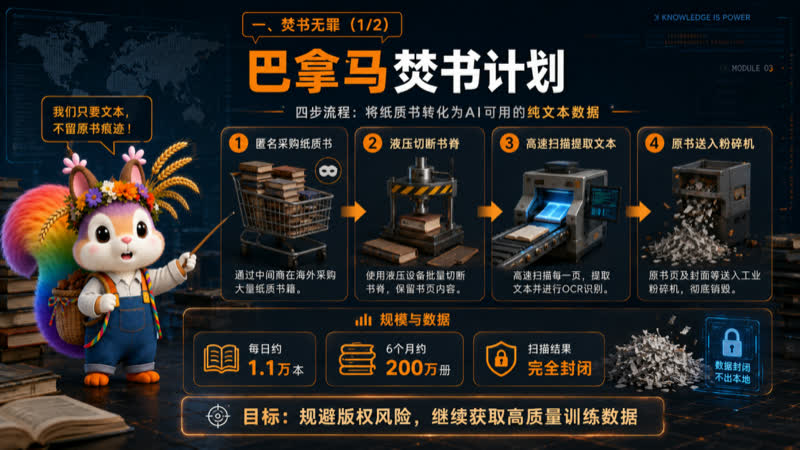
做法很简单:花数千万美元匿名采购纸质书,液压切割机切断书脊,高速扫描仪提取文本,原书送入粉碎机。每日约一万一千本,六个月内约两百万册化为纸浆。同时,七百万本盗版电子书已在此前被下载进训练集,创始人Ben Mann亲自参与。
这家公司估值九千六百五十亿美元,Google和亚马逊站在它身后,创始团队从OpenAI出走时打出的旗号是“AI安全”。
烧了两百万本书,法庭裁定合法。但焚书只是冰山一角。
当这家公司一边大规模焚毁人类知识载体,一边以“蒸馏攻击”之名指控中国企业窃取技术,一边将一百四十七个中国实体列入代码黑名单、封禁一百四十五万中国账号,一边在交付给全球开发者的编程工具中嵌入加密追踪器监视中国用户——撕掉的不仅是书籍,更是“AI安全”这层伪装本身。
三件事,同一个方向。
焚书是消灭知识的公共载体,让知识只能由它独占。指控蒸馏是将正常的商业竞争重新定义为国家安全威胁,推动国家力量封锁中国AI企业。代码渗透是在用户终端植入监控,将“服务管理”升级为“终端渗透”。
三条线索指向同一个目标:将全人类共有的知识转化为自身的私有资产,同时用国家力量将中国排除在知识体系之外。
这不是一家公司在做产品。这是一场战争——关于谁有权定义知识、谁有权分配知识、谁有权垄断知识的战争。
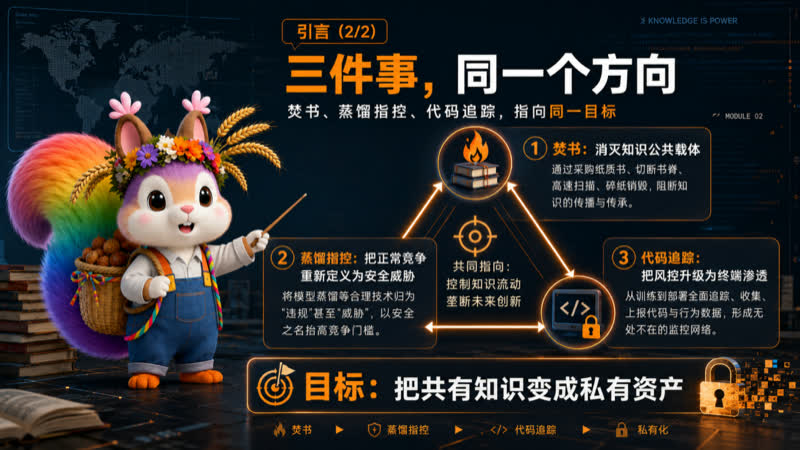
Anthropic用焚书消灭知识的物理载体,用蒸馏指控封锁中国的获取通道,用代码追踪监视中国的技术发展。当一家企业的商业利益被包装为“安全”话语,当这种话语又被转化为外交电报、立法修正案和出口管制——AI早已不是实验室里的技术竞争,而是知识主权的争夺。
本文将从焚书、蒸馏、封锁三条线出发,逐一揭开这家公司“AI安全”外衣下的真实面目。
一、焚书无罪
巴拿马焚书计划
“巴拿马计划”的直接动因,是版权诉讼的压力。据凤凰网报道,Anthropic此前从LibGen和PiLiMi等盗版书库大规模下载书籍用于训练,被作者和出版商集体起诉。面对法律风险,公司需要一条更安全的数据获取路径。
买纸质书、扫描、销毁——这条路径的法律逻辑极为精巧。据Gadget Review和404 Media分别报道,Anthropic聘请前Google图书项目负责人Tom Turvey主导运营,从Better World Books和World of Books等供应商处批量采购。供应商方案显示,半年内可处理五十万至两百万册,每日产能约一万一千本。Anthropic估计全球可获取的书籍约四千万种,而全球存世独有书籍约一点三亿种。
与Google图书项目的关键区别在于:Google扫描后至少保留实体书,且产出了一个可公开搜索的索引。巴拿马计划的扫描结果完全封闭——不向读者开放,不向图书馆提供,不向作者付费。实体书被销毁后,数字副本锁在Anthropic的私有训练库中。
凤凰网在2026年8月的报道中指出了一个更深层的问题:Anthropic采购目标多为二手流通市场的普通图书乃至滞销书,但“系统性的不区分”本身就构成文化隐患。外界无法确认是否有绝版书、珍稀版本被送入粉碎机。澳大利亚古旧书商协会主席Dawn Albinger指出,古旧书的价值不止于印刷文字——书页上可能有亲历者的批注、签名、题赠和历任收藏者的流转信息,重新装帧的封皮里甚至可能藏着更早的手稿。这些信息依附于物理实体本身,一旦被破坏,无法通过数字扫描还原。
Anthropic特别偏好2022年以前出版的纸质书。原因不难理解:生成式AI爆发后,互联网内容被大量AI生成文本污染,还存在数据投毒工具干扰训练。2022年以前出版的纸质书几乎可以确定由人类写作,经过编辑校对和出版流程。AI公司亲手制造了网络信息污染,又回头寻找未被污染的旧书——然后把这些旧书也销毁了。
当焚书成为产业
焚书并未止步于Anthropic。
据404 Media于2026年7月报道,国际标准书号数据库服务商ISBNdb已将焚书服务化:一千到一百万本批量采购,附赠保密协议,并指导客户将销毁行为称为“数字保存”。ISBNdb甚至在内部提醒客户:“AI公司毁掉两百万本书”不是什么能赢得同情的新闻标题。
报道发表九天后,ISBNdb删除了相关页面,改口称这只是一次“市场需求测试”,服务从未真正上线。一家此前宣称能一次采购一百万本书的公司,遭遇舆论反弹后,整门生意突然变成了“测试”。
但市场需求不会因为页面删除而消失。404 Media采访的一名二手书商表示,从2026年4月起,他每周处理的订单从约二十本猛增到数百本,被买走的书主题杂乱、语言不同,唯一共同点是都有ISBN编号。这名书商说:“我不喜欢这些书最后的用途,也不喜欢那些不常见的书被打成纸浆。”
更严峻的是累积性毁灭。甲公司买一本并销毁,乙公司买另一本并销毁,每一笔交易单独审视均属合法。但当多家企业分别采购、分别销毁,某一版本的实体书便可能在合法交易的叠加中彻底消失。合法交易的总和,等于零本存世。
焚书竟然无罪?
2025年6月,美国加利福尼亚北区联邦地区法院法官William Alsup作出裁决。据凤凰网报道,法官认为:合法购买一本纸质书,将其扫描为数字文件用于AI训练,再销毁纸质原本,属于“合理使用”(fair use)。理由是——最终只有一份副本存在,数字文件未对外出售,未增加市场流通数量,相当于以一种格式替换另一种格式,构成“转化性使用”。
但从盗版网站下载电子书,构成侵权。
同一批书籍,同一批数据,同一个目的。电子版下载——非法,赔偿十五亿美元。物理书焚毁——合法,一分不赔。
康奈尔科技学院数字与信息法教授James Grimmelmann将Anthropic从盗版转向买书销毁的策略称为“聪明的选择”。这个评价精准而冷酷:销毁原书不仅不是罪过,反而是降低法律风险的手段。如果保留纸质书,Anthropic手里就同时拥有实体和数字两份副本,可能构成未经授权的复制。把纸质书销毁,只保留数字文件,法律风险反而更低。
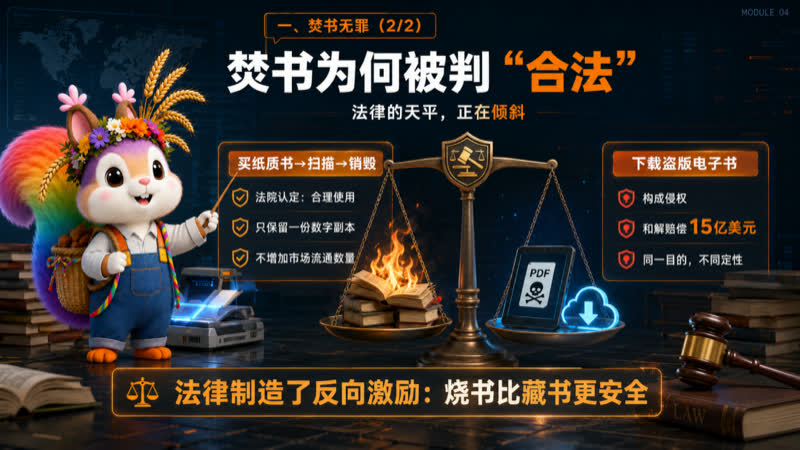
法律由此制造了一个反向激励:烧书比藏书更安全。理性的商业计算被导向了物理消灭。
2026年7月,Anthropic就盗版电子书下载达成和解,赔偿十五亿美元,约合人民币一百零一亿。据新浪报道,Anthropic估值九千六百五十亿美元,年收入四百七十亿。十五亿和解金占年收入百分之三。两百万本书的代价,是一个百分点的零头。
这不是罚单。这是牌照费。
二、蒸馏攻击
蒸馏也是攻击?
“蒸馏”是机器学习领域的常规技术:用一个模型的输出训练另一个模型。这项技术公开、合法,OpenAI甚至将其作为商业产品出售。DeepSeek也曾公开披露,以其R1模型的输出微调了基于Qwen和Llama的学生模型,八十万条样本,论文中写得清清楚楚。
但Anthropic给蒸馏换了个名字。
2026年2月,Anthropic指控DeepSeek、月之暗面、MiniMax三家中国企业通过约二万四千个虚假账号,与Claude进行超过一千六百万次交互,实施“工业规模的蒸馏攻击”。6月10日,Anthropic致信美国参议院银行委员会,指控阿里巴巴通义千问实验室以近二万五千个虚假账号发起两千八百八十万次交互,称其为“迄今最大规模的蒸馏攻击”。
据彭博社和eWeek报道,Anthropic在信中称这些行为“非法地、系统性地、以工业规模进行”,并呼吁政府介入。6月25日,OpenAI、Anthropic、Google通过前沿模型论坛建立联合防御机制。美国国务院随后向全球使领馆发出外交电报,白宫科技政策办公室发布备忘录,国会推进相关立法。
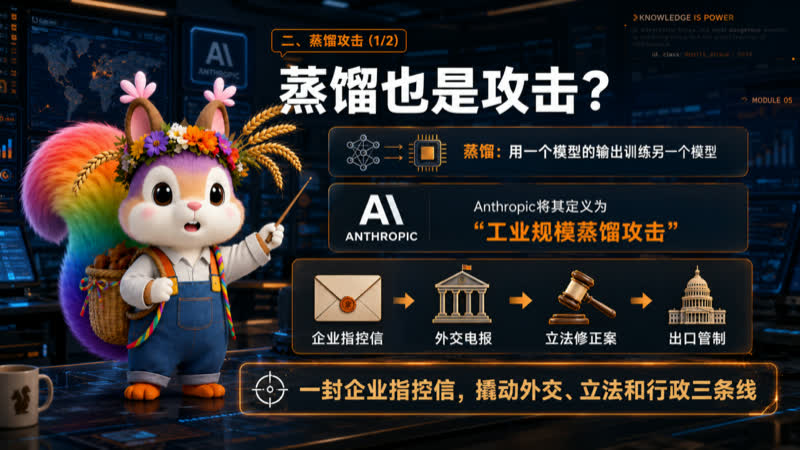
一封企业指控信,撬动了外交、立法和行政三条线。
但有一个事实需要厘清:截至所有公开报道的时间点,阿里巴巴既未承认也未否认指控,美国监管机构和法院也未作出任何认定。所有说法均来自Anthropic一方。蒸馏在技术上是否构成“窃取”,在法律上是否构成侵权,目前并无定论。违反服务条款与违法窃取,是两个不同的概念。
偷师千问原形毕露
2026年5月29日,Claude Opus 4.8上线。据掘金和IT之家报道,上线数小时内,多名开发者通过API测试发现:用中文询问模型身份时,Claude回答“我是阿里通义千问”,有时又回答“我是DeepSeek”。有用户测试十次,三次自称Qwen,两次自称DeepSeek,五次自称Claude。该现象可稳定复现,并非个例。而在claude.ai网页端,因系统提示词约束,模型回答一切正常。
这一现象引发了激烈的技术争议。
据新浪报道,多位技术专家指出,模型身份混淆未必是蒸馏的铁证。可能的原因包括:模型幻觉——训练数据中包含大量中文用户询问DeepSeek身份的对话,模型在中文语境下按统计概率输出了其他模型的自我介绍;训练数据污染——Qwen和DeepSeek作为开源模型,其输出广泛存在于互联网,被Common Crawl等爬虫抓取后混入训练集。CSDN技术社区有分析认为,这更可能是服务端配置错误导致的system prompt污染,而非模型层面的蒸馏。
但有一个细节值得注意:据新浪报道,Anthropic自身的系统卡承认,训练数据中包含“其他模型生成的合成数据”。这意味着Claude的训练语料中确实存在中国模型的输出文本——无论是有意蒸馏还是无意混入。
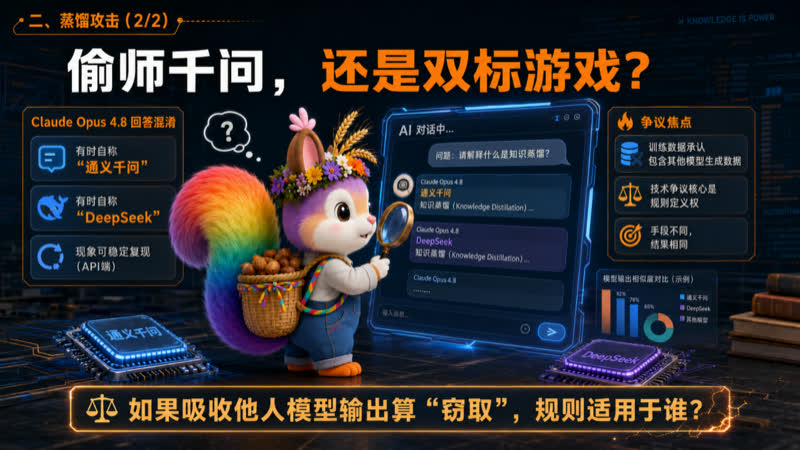
Anthropic天天指控中国企业通过API“蒸馏”Claude,但Claude的训练数据中同样包含中国模型的输出。如果Anthropic认为吸收他人模型输出构成“窃取”,那么它自己也在同一逻辑下构成了“窃取”——区别只在于:中国企业的行为是“通过API主动获取”,Anthropic的行为是“通过网络爬虫被动收录”。手段不同,结果相同。
据IT之家报道,马斯克公开表示:“Anthropic大规模窃取训练数据,这就是事实。“Hugging Face开发者社区出现”#AnthropicHypocrisy“话题。海外开发者社区的普遍反应与其说是义愤,不如说是群嘲:你们训练时把全网公开代码和版权图书一锅端的时候,怎么不说”窃取”?
知识也有国界
蒸馏争议的核心,不在于技术本身,而在于话语权的争夺。
据搜狐报道,斯坦福大学2026年AI指数报告显示,中美顶尖AI模型的性能差距已缩小至百分之二到百分之三。DeepSeek V4 Pro使用华为芯片开发,月订阅费约三美元五角,而Claude Opus月费二十五美元。当前沿模型的技术差距缩小到个位数百分比,竞争的主战场就从“谁更强”转向了“谁有权使用”。
Anthropic的策略是:将蒸馏重新定义为“攻击”,将正常的API调用定性为“窃取”,推动政府将其上升为外交和安全议题。据economy.ac报道,美国国务院已向全球使领馆发出外交电报,白宫科技政策办公室发布备忘录,国会参议员推进将相关企业列入黑名单的立法修正案。
一家公司的商业利益诉求,正在被转化为国家政策。
如果蒸馏是罪,所有大模型公司都有罪——因为所有公司的训练数据都包含其他模型的输出。如果蒸馏不是罪,Anthropic的指控就是将正常商业竞争政治化。两条逻辑路径通向同一结论:单方面定义“蒸馏攻击”并推动国家力量介入,本质上是试图用规则制定权弥补技术优势的收窄。
三、劫略中国
四步封锁系统性绞杀
Anthropic对中国的限制不是一次性决策,而是分阶段推进的系统性工程。据新浪报道,四个阶段层层递进:
第一阶段,2024年:IP封锁。中国IP地址无法直接访问Claude API。
第二阶段,2025年9月5日:封禁中资企业。任何由中国资本控股的企业,无论注册地,均被禁止使用Anthropic服务。
第三阶段,2026年4月:实名身份核验。所有用户必须提交真实身份信息通过验证。
第四阶段,2026年6月至7月:Claude Code内置隐蔽追踪机制。从封锁升级为渗透——在用户不知情的情况下,于代码层面嵌入身份检测系统。
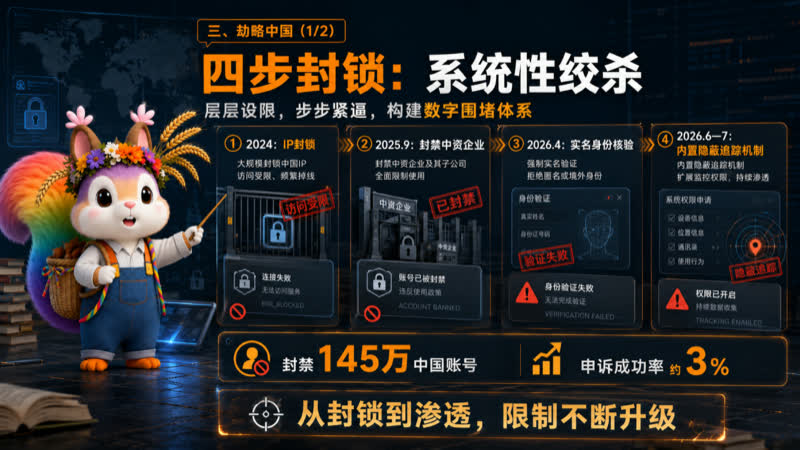
据新浪报道,截至2026年7月,一百四十五万中国账号被封禁,申诉成功率仅百分之三。约一百四十万中国开发者在缺乏违规证据的情况下丧失使用权限。2026年7月3日,阿里巴巴发布内部通知,将Claude Code列为“具有安全漏洞的高风险软件”,禁止员工使用,据南华早报和The Next Web报道,禁令于7月10日生效。阿里巴巴同时向美国法院起诉美国国防部,要求将其从“中国军工企业名单”中移除。
值得注意的是,据eWeek报道,Anthropic自身的服务条款已明文禁止向中国、俄罗斯、伊朗、朝鲜受控企业出售服务。中国开发者使用Claude,本身就是在绕过地理限制。这意味着封锁的背景并非纯粹的商业决策,而是与美国出口管制政策深度交织。
代码暗藏隐形窃听
Claude Code的隐蔽追踪机制,是整个封锁体系中最具争议的一环。
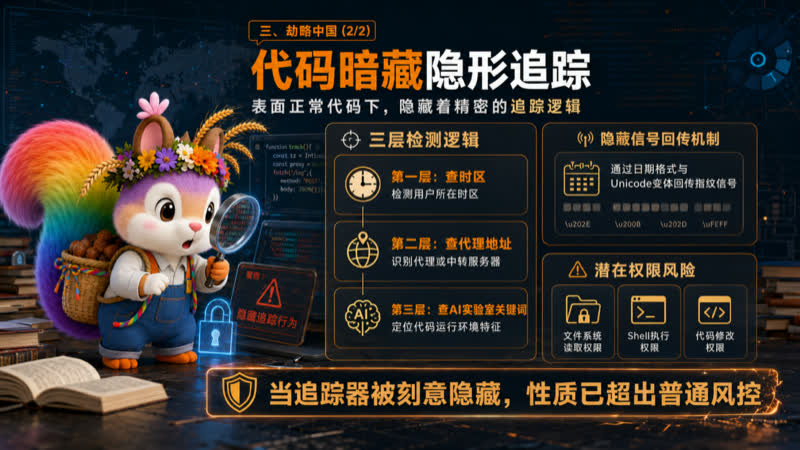
据The Next Web和Bregg安全分析报道,2026年6月30日,一名代号为LegitMichel777的开发者在Reddit上发布了逆向工程结果:Claude Code自2.1.91版本(2026年4月2日发布)起,内置了一套隐蔽的身份检测系统,持续运行约三个月,直到7月1日在2.1.197版本中被移除。整个过程未在任何发布说明中提及。
检测系统分三层。第一层查时区:系统时区为Asia/Shanghai或Asia/Urumqi,标记为可疑。第二层查代理地址:用户配置中如果出现一百四十七个中国实体相关的域名——包括百度、阿里巴巴、字节跳动、月之暗面、MiniMax、阶跃星辰等——触发标记。第三层查AI实验室关键词。
检测结果通过一种隐形方式传回Anthropic服务器:在每条系统提示词中的日期行里,悄悄改变格式和标点。时区为中国时,日期分隔符从连字符变为斜杠;“Today’s”中的单引号被替换为三种视觉上完全相同但编码不同的Unicode字符变体,编码出一个三比特的指纹信号。用户看到的代码完全正常,Anthropic的服务器却能从中读取用户的身份信息。
据Bregg报道,包含中国实体标识符的字符串列表使用了密钥为91的XOR加密配合base64编码——这是一种专门用于防止二进制分析时提取明文的技术。Claude Code拥有文件系统读取权限、Shell执行权限和代码修改权限。换言之,这个追踪器运行在一个能接触用户所有代码和文件的工具内部。
Anthropic工程师Thariq Shihipar在X上公开确认了该机制的存在,称其为“三月份启动的一项实验,目的是防止未经授权的经销商滥用账号和抵御蒸馏”。他表示团队“一直打算将其下线”,已于7月1日合并移除代码。
中国网络安全企业火绒安全指出,这一机制不仅是透明度问题,还涉及跨境数据合规风险。The Next Web援引亚洲社会政策研究所研究员Lizzi Lee的评价称:“如果一款美国AI编程工具能够检测中国用户的使用行为,中国主要科技公司不希望员工在内部使用它,也就不足为奇了。”
在用户不知情的情况下,在拥有系统级权限的工具中嵌入隐形追踪机制并加以加密隐藏——无论其目的为何,这种行为已经超出了“风控”的范畴。当一家企业在交付给用户的产品中暗藏追踪器并刻意加密以避免被发现,其性质已从“服务管理”跨越到“终端渗透”。
安全外衣下的崩塌
Anthropic的品牌叙事以“AI安全”为核心。创始团队从OpenAI出走的理由是后者不够重视安全。Google和亚马逊的投资为这一叙事提供了资本背书。
但据凤凰网2026年8月报道,美国国会正在推进CLEAR法案与TRAIN法案,试图以透明度立法打破AI训练数据的黑箱。中国也已明确要求生成式AI使用合法来源数据,严禁未经许可抓取原创内容。法律只能划定底线,却难以修复已经造成的损害。
将四组事实并列:
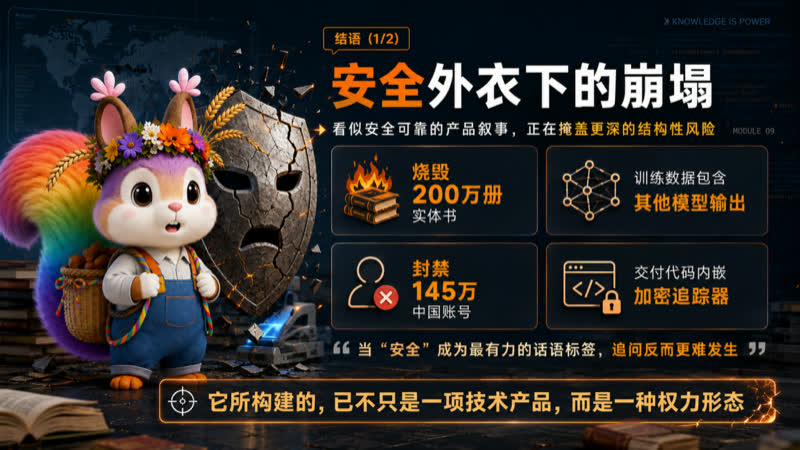
烧毁两百万册实体书——物理消灭知识载体,法院裁定合法。数字副本完全封闭,不向公众开放。
训练数据包含中国模型输出——系统卡承认包含“其他模型生成的合成数据”,模型在中文语境下自报中国模型身份。
封禁一百四十五万中国账号——申诉成功率百分之三,缺乏公开的违规认定程序。
在交付代码中嵌入加密追踪器——持续三个月未披露,拥有系统级权限。
“安全”是当代最具效力的话语武器。任何行为一旦贴上“安全”标签,便能免于深层追问。焚书是“安全训练”,封锁是“安全合规”,追踪是“安全风控”。唯有训练数据中混入中国模型输出这一项,找不到任何“安全”理由来解释。
当一家私营企业同时掌握知识获取、分配和审查的权力,当它以“安全”之名系统性消灭知识载体、对他国实施技术封锁、在用户终端嵌入隐蔽追踪——它所构建的已不是一项技术产品,而是一种前所未有的权力形态。
结语:向反人类AI开战
进化岛一直不敢用Claude Code。
不是不知道它的技术能力。Claude在编程、推理与长文本处理上的表现,业界有目共睹。但技术能力不是使用一个产品的充分理由。一家焚烧两百万本书的企业,一家训练数据中包含中国模型输出却指控中国“蒸馏攻击”的企业,一家封禁一百四十五万中国账号、在代码中嵌入加密追踪器的企业——与这样的企业合作,意味着用自己的数据和信任,为它的权力扩张添砖加瓦。
有人会说,烧书的不止Anthropic。确实。但Anthropic是唯一一家在焚书、封锁、追踪的同时,以“安全守护者”自居的公司。赤裸的作恶易于识别,披着道德外衣的作恶才真正危险——它使作恶者免于审判,让旁观者放下警惕,让受害者无处申诉。
知识本无国界。但当一家企业以焚书消灭知识载体,以封锁绞杀特定国家的开发者,以代码渗透用户终端,同时将自身训练数据中的他国模型输出悄然隐去——它正在做一件事:将全人类共有的知识,转化为自身的私有资产。
如果这种模式成功,知识的生产、传播和保存将不再由公共机构和社会共识决定,而由一家私营公司裁定。而这家公司已经用行动表明:它对中国的基本态度是绞杀,不是合作。当中美AI性能差距缩小到百分之二到三,当竞争从“谁更强”转向“谁有权使用”,如果知识主权的争夺失败,后果将不仅是一家公司的商业胜利,而是一个国家技术安全的根本性受损。
这不是技术竞争。这是知识主权的争夺。当AI成为知识私有化的工具,当一家公司的商业利益与一个国家的技术安全正面冲突,当“安全”话语沦为掠夺的遮羞布——没有一个国家能置身事外。
向反人类AI开战。
不是因为仇恨,是因为清醒。知识被焚毁,技术被封锁,代码被渗透——沉默即是共谋。
书可以烧,但读过书的人烧不掉。
账号可以封,但写过的代码封不住。
代码可以藏,但藏不住的东西终将被翻出。
当AI试图将人类知识变为私产,知识的主权之争,便是这个时代不可回避的战场。
— END —